IA: del enchufe a la pantalla
Detrás de una respuesta hay electricidad, ordenadores y un programa preparado de antemano. Recorremos el camino con una comparación de cocina.
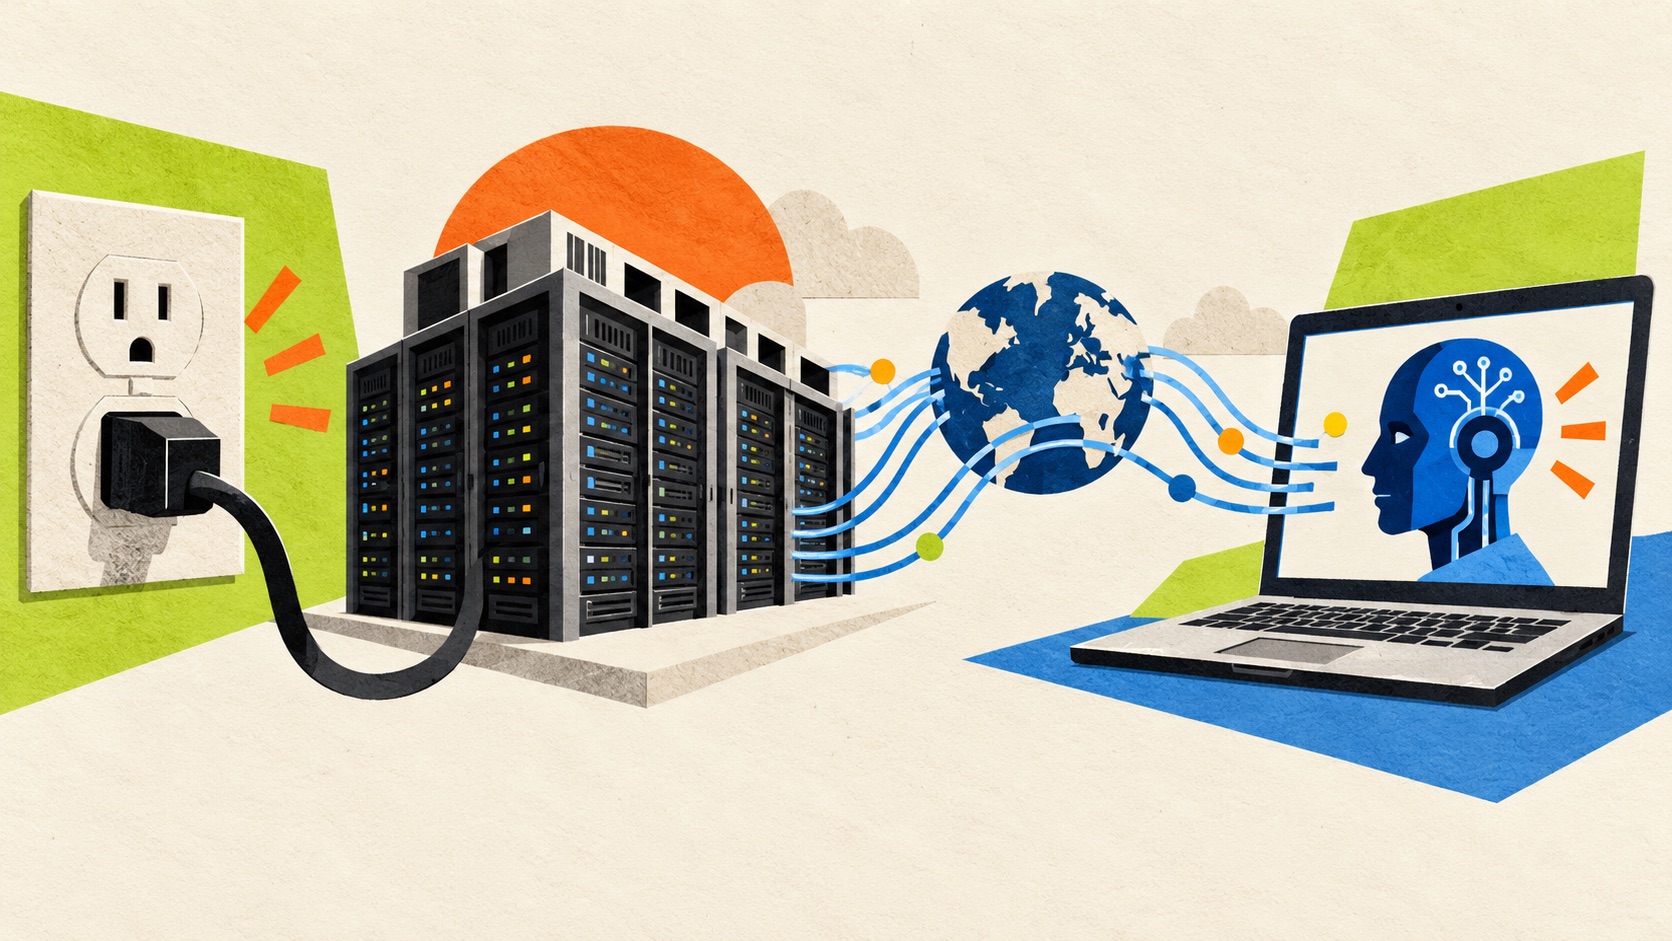
Pides una explicación a la inteligencia artificial y aparece un texto en el móvil. Parece sencillo. También lo parece pedir un plato en un restaurante: ves lo que llega a la mesa, pero detrás hay electricidad, aparatos y preparación previa. Vamos a entrar en esa cocina.
Seguiremos el recorrido habitual de un servicio de texto que funciona por internet. Los detalles cambian según la herramienta.
Primero, hay que encender la cocina
La electricidad alimenta un centro de datos: instalaciones donde trabajan muchos ordenadores. Los llamados servidores son esos ordenadores; los armarios que los contienen son otra cosa. Al funcionar desprenden calor, así que necesitan refrigeración. No basta con alimentar los cálculos: mantener los equipos a una temperatura adecuada también consume energía.
Los aparatos hacen el trabajo pesado
Dentro de los equipos hay procesadores. Uno habitual, la CPU, atiende tareas variadas y también puede trabajar en paralelo. La GPU, o procesador gráfico, destaca al hacer muchas operaciones parecidas a la vez. Eso resulta útil para los cálculos de la IA. No es el único tipo de chip que puede ejecutarlos.
La preparación empezó antes de tu pedido
Los programas utilizan un modelo de lenguaje entrenado previamente. Antes de atender preguntas, el sistema practica con grandes conjuntos de datos: intenta predecir texto y se ajustan sus valores numéricos. Así aprende patrones. No hay que suponer que ha leído todo internet.
Muchos modelos utilizan una estructura llamada Transformer. Su mecanismo de «atención» calcula qué relaciones entre fragmentos del texto importan para procesarlo. La palabra suena humana, pero describe operaciones matemáticas, no un cerebro dentro del ordenador.
Ahora sí: llega tu pregunta
Tu mensaje viaja por internet hasta el servicio. Se divide en fragmentos llamados tokens: pueden ser palabras, partes de palabras o signos. El sistema los representa mediante números para poder calcular.
Con la pregunta y el texto que lleva generado, el modelo calcula probabilidades para el siguiente fragmento. El proceso se repite y forma la respuesta. Puede sonar convincente y contener errores: una continuación probable no garantiza un dato verdadero.
Usar el modelo ya preparado se llama inferencia. No equivale a repetir su entrenamiento con cada pedido. La respuesta vuelve al móvil y puede aparecer por partes mientras se genera; no siempre tarda lo mismo.
¿Para qué te sirve?
No toda IA necesita esa gran cocina lejana: hay modelos pequeños que funcionan en ciertos móviles y ordenadores personales. Depende del modelo y de los recursos del aparato.
Quédate con el recorrido: electricidad, equipos, modelo preparado y respuesta en pantalla. Ahora sabes qué hay detrás. Si el texto te indica cómo hacer un trámite, comprueba los pasos en la web del organismo responsable antes de actuar.
CONFIRMADO
Explicación general contrastada con las fuentes citadas. No describe la instalación concreta de un servicio ni mide el consumo de una pregunta.
Fuentes: Agencia Internacional de la Energía: electricidad y centros de datosGoogle: fragmentos de texto y generación mediante probabilidades
+6 fuentes
- NVIDIA: diferencias entre CPU y GPU
- Google: entrenamiento de los modelos de lenguaje y sus limitaciones
- Google Research: cómo funciona la atención en un Transformer
- Hugging Face: cómo se convierte el texto en números y viceversa
- Google: peticiones al servicio y entrega progresiva de respuestas
- Google DeepMind: modelos que funcionan en dispositivos personales